Финал кок-бору


Отправить решение Решать в редакторе

Сложность: 100%
Очки: 100 (частичный балл)
Ограничение по времени: 3.0s
Ограничение по памяти: 512M

Автор:
Типы задач
Разрешённые языки
C, C#, C++, F#, Go, Java, JavaScript, Kotlin, Pascal, Python, Scratch

Кок-бору — древняя конная игра кочевников и главный вид программы Всемирных игр кочевников. Федерация кок-бору Кыргызстана готовит национальный чемпионат: в каждом из n сёл есть своя команда, а сёла соединены n − 1 дорогами так, что между любыми двумя сёлами есть ровно один путь (дороги образуют дерево).

Каждая пара команд сыграет между собой один матч. Расстоянием между сёлами назовём количество дорог на пути между ними: столько дней гостям нужно добираться верхом с табуном. Чтобы спланировать расходы на переезды, федерации нужна таблица: для каждого k от 1 до n − 1 — сколько пар сёл находятся на расстоянии ровно k.
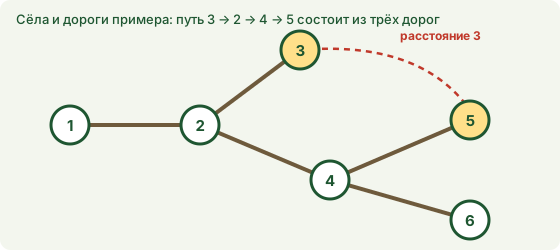
Рисунок

Входные данные

В первой строке — целое число n (1 ≤ n ≤ 200 000).

В каждой из следующих n − 1 строк — два числа a и b (1 ≤ a, b ≤ n): дорога между сёлами a и b. Гарантируется, что дороги образуют дерево.

Выходные данные

Выведите в одной строке n − 1 чисел: k-е число — количество неупорядоченных пар сёл на расстоянии k. Если n = 1, выведите пустую строку.

Пример 1

Вход:

6
1 2
2 3
2 4
4 5
4 6

Выход:

5 6 4 0 0

Пояснение

На расстоянии 1 находятся 5 пар (по одной на каждую дорогу), на расстоянии 2 — пары 1–3, 1–4, 3–4, 2–5, 2–6, 5–6, на расстоянии 3 — пары 1–5, 1–6, 3–5, 3–6. Сёл на расстоянии 4 и 5 нет.

Система оценивания

Подзадача Баллы Дополнительные ограничения
1 10 n ≤ 3000
2 20 дороги соединяют сёла i и i + 1
3 20 n ≤ 20 000
4 50 без дополнительных ограничений

Баллы за подзадачу начисляются, только если пройдены все её тесты.

Примечание

Ответы могут превышать 2³¹ — используйте 64-битные целые числа.


Комментарии


  • 0
    Elnurbek  прокомментировал 27 Окт. 2026, 7:16 д.п.

    import sys

    Настройка лимита рекурсии для глубоких деревьев

    sys.setrecursionlimit(300000)

    def solve():

    # Быстрый ввод данных
    input = sys.stdin.read
    data = input().split()
    if not data:
        return
    
    n = int(data[0])
    if n == 1:
        print("")
        return
    
    # Строим список смежности графа
    adj = [[] for _ in range(n + 1)]
    idx = 1
    for _ in range(n - 1):
        u = int(data[idx])
        v = int(data[idx+1])
        adj[u].append(v)
        adj[v].append(u)
        idx += 2
    
    # Массив для хранения итоговых ответов для каждого расстояния k
    # Итоговый ответ может быть большим, Python автоматически поддерживает длинную арифметику
    ans = [0] * n
    
    # Инициализация массивов для центроидной декомпозиции
    deleted = [False] * (n + 1)
    subtree_size = [0] * (n + 1)
    
    # Вспомогательная функция для подсчета размеров поддеревьев
    def get_sizes(u, p):
        subtree_size[u] = 1
        for v in adj[u]:
            if v != p and not deleted[v]:
                get_sizes(v, u)
                subtree_size[u] += subtree_size[v]
    
    # Функция поиска центроида текущей компоненты
    def get_centroid(u, p, comp_size):
        for v in adj[u]:
            if v != p and not deleted[v] and subtree_size[v] > comp_size // 2:
                return get_centroid(v, u, comp_size)
        return u
    
    # Функция сбора всех глубин (расстояний) в текущем изолированном поддереве
    def collect_depths(u, p, d, current_depths):
        if d >= len(current_depths):
            current_depths.append(0)
        current_depths[d] += 1
        for v in adj[u]:
            if v != p and not deleted[v]:
                collect_depths(v, u, d + 1, current_depths)
    
    # Главный стек/очередь для итеративного или рекурсивного обхода декомпозиции
    # Использование стека вместо чистой рекурсии защищает от переполнения стека вызовов
    stack = [1]
    
    while stack:
        u = stack.pop()
    
        get_sizes(u, -1)
        comp_size = subtree_size[u]
        if comp_size <= 1:
            continue
    
        centroid = get_centroid(u, -1, comp_size)
        deleted[centroid] = True
    
        # Сюда мы будем собирать суммарное распределение глубин для уже обработанных поддеревьев центроида
        # Изначально у нас есть только сам центроид на расстоянии 0
        total_depths = [1]
    
        for v in adj[centroid]:
            if not deleted[v]:
                current_depths = [0] # 0-й индекс пустой, так как вершины начинаются с расстояния 1
                collect_depths(v, centroid, 1, current_depths)
    
                # Чтобы слияние было быстрым (оптимизация Small-to-Large),
                # мы всегда гарантируем, что total_depths не меньше current_depths.
                # Если текущее поддерево глубже, расширяем total_depths.
                if len(total_depths) < len(current_depths):
                    total_depths.extend([0] * (len(current_depths) - len(total_depths)))
    
                # Считаем пары между вершинами из нового поддерева и ранее обработанных
                for d_curr, count_curr in enumerate(current_depths):
                    if count_curr == 0:
                        continue
                    for d_tot, count_tot in enumerate(total_depths):
                        if count_tot == 0:
                            continue
                        dist = d_curr + d_tot
                        if dist < n:
                            ans[dist] += count_curr * count_tot
                        else:
                            break # Расстояния больше n нам не интересны
    
                # Добавляем вершины текущего поддерева в общий пул глубин для этого центроида
                for d_curr, count_curr in enumerate(current_depths):
                    total_depths[d_curr] += count_curr
    
        # Добавляем смежные вершины в стек для обработки следующих компонент
        for v in adj[centroid]:
            if not deleted[v]:
                stack.append(v)
    
    # Вывод результатов в одну строку через пробел
    print(*(ans[1:]))

    if __name__ == '__main__': solve()